离线语音转写技术全解读 数据不上云,准确率为何还能超95%?
在数据隐私日益受到重视的今天,离线语音转写技术正悄然成为行业焦点。它实现了“数据不出设备”的承诺,却又矛盾般地宣称准确率超过95%。这背后并非魔法,而是数据技术、模型压缩与端侧计算共同进化的结果。
一、从“上云”到“端侧”:语音转写的范式转移
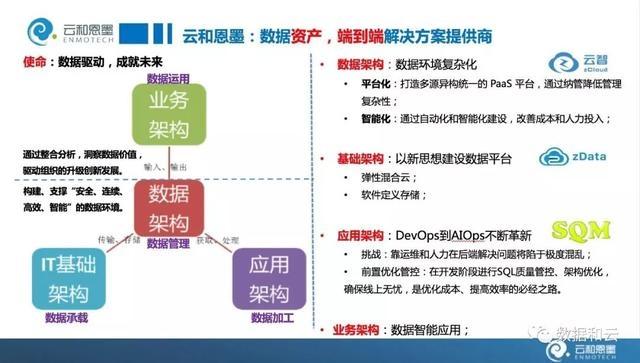
传统云端语音转写要求音频上传至服务器,由强大算力完成识别。这虽然能利用海量数据训练的大模型,但存在延迟、网络依赖和隐私风险。离线转写则将整个识别过程部署在本地设备——手机、电脑或嵌入式芯片上。没有网络传输,没有云端存储,数据始终留在用户手中。
然而端侧设备算力与内存有限,早期离线方案准确率往往不足80%,只能处理简单指令。直到深度学习与模型压缩技术突破,才让高精度离线转写成为可能。
二、准确率超95%的三大技术支柱
1. 端到端模型与大数据预训练
现代离线语音识别普遍采用端到端架构(如RNN-T、Conformer),取代了传统的声学模型、发音词典、语言模型分离的流水线。端到端模型直接映射音频到文字,减少了误差传递。
关键在于,这些模型并非在设备上从零训练。它们先在云端利用数万小时标注语音、数十亿文本语料进行大规模预训练,学习到丰富的声学与语言规律。然后,通过知识蒸馏、量化、剪枝等技术,将大模型“浓缩”为可在端侧运行的轻量模型。预训练数据越大、覆盖场景越广,模型泛化能力越强,这是准确率的根本来源。
2. 模型压缩与硬件加速
原始语音识别模型可能数百MB甚至上GB,无法在手机运行。离线方案采用:
- 量化:将32位浮点权重压缩为8位整数,体积缩小4倍,推理速度提升2-4倍,精度损失极小。
- 剪枝:移除冗余连接和神经元,降低计算量。
- 知识蒸馏:用大模型(教师)指导小模型(学生)训练,让学生模仿教师的输出分布,从而在更小体积下保持高准确率。
- 神经架构搜索(NAS):自动设计适合端侧的高效网络结构。
经过压缩,模型可降至几十MB,同时借助设备NPU、DSP等硬件加速,实现实时推理。
3. 自适应与语境增强
端侧模型虽小,却可以个性化。离线转写常在本地收集用户常用词、联系人、地名等,动态更新语言模型或偏置解码,提高特定场景下的准确率。利用音频上下文(如前后词)和本地语言模型协作,可进一步纠正同音字错误。虽然端侧数据有限,但聚焦于用户实际使用场景,特征分布更集中,反而能实现较高的实际准确率。
###三、实测准确率超95%吗?分清条件
值得注意的是,“超95%”的准确率通常指词错误率(WER)低于5%,且满足以下条件:
- 朗读式、清晰、安静环境下的标准普通话/英语;
- 涵盖常见词汇与句式;
- 测试集与训练数据分布相似。
在嘈杂环境、远场、方言口音、专业术语密集的场景,离线转写准确率会大幅下降,可能只有70%-85%。即便云端大模型,也会面临同样挑战。因此“95%”更多是理想基准,而非普适承诺。
四、数据技术的胜利:隐私与效能兼得
离线语音转写的核心逻辑是:用技术厚度换数据外传。通过算法将大数据预训练的知识“塞进”小模型,并在端侧利用设备算力完成高维推理。它并非依赖在线数据积累来提升性能——每次识别结果不会默认回传——而是靠模型泛化能力和本地适配。
从数据技术视角,这标志着一个重要转折:智能不必以牺牲隐私为代价。边缘计算的算力增长、模型压缩算法进步、以及联邦学习等技术的补充,将使离线语音交互更加可靠。离线转写将不仅限于快捷键词语,而可能承载完整的会议记录、实时字幕下载生成,在合规性与用户体验间找到新的平衡。
所以说,数据不上云,准确率还能超过95%,背后是云侧练就的“深厚内功”与端侧创新的压缩协作。离线语音转写的阈值,仍在持续推高。
如若转载,请注明出处:http://www.bzhile.com/product/33.html
更新时间:2026-09-15 10:19:43